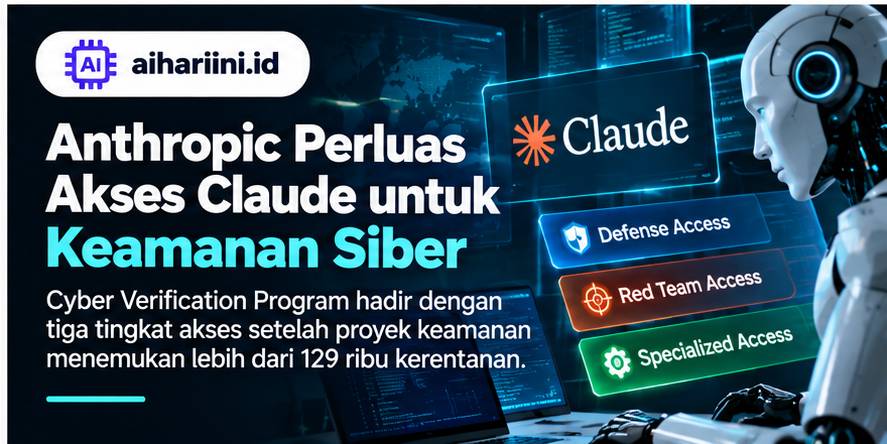
AiHariIni mencatat Anthropic memperluas akses terhadap kemampuan keamanan siber pada model Claude melalui versi baru Cyber Verification Program. Program yang diumumkan 6 Oktober 2026 tersebut menghadirkan tiga tingkat akses dan mencakup model Claude Opus 5.5, Claude Sonnet 5.5, serta Claude Mythos 5.1 untuk tim keamanan yang memenuhi persyaratan.
Langkah ini menarik karena perusahaan AI biasanya memasang pengaman cukup ketat pada permintaan berkaitan dengan eksploitasi software.
Masalahnya, pekerjaan profesional keamanan siber sering menggunakan teknik yang sama dengan penyerang.
Perbedaannya berada pada izin serta tujuan.
Anthropic Cyber Verification Program Memiliki Tiga Tingkat
Versi baru program membagi akses menjadi Defense, Red Team, dan Specialized.
Masing-masing memiliki tingkat verifikasi serta pengamanan berbeda.
Defense Access ditujukan untuk pekerjaan seperti incident response dan analisis malware.
Tim keamanan membutuhkan kemampuan memahami kode berbahaya, pola serangan, dan perilaku software untuk mengetahui bagaimana sebuah insiden terjadi.
Red Team Access memberi kelonggaran lebih besar.
Akses ini ditujukan bagi organisasi yang melakukan penetration testing resmi atau pengujian keamanan dengan izin.
Pada pekerjaan semacam ini, tim memang perlu mencoba menemukan kelemahan sebelum penyerang sungguhan melakukannya.
Specialized Access menjadi tingkat yang paling sensitif.
Kategori ini diperuntukkan bagi organisasi terverifikasi yang menangani sistem keselamatan kritis, termasuk infrastruktur seperti jaringan listrik atau sistem penerbangan.
Mengapa Claude Biasanya Membatasi Permintaan Cyber?
Keamanan siber merupakan bidang dual-use.
Instruksi untuk menemukan kelemahan dapat membantu developer memperbaiki sistem.
Namun instruksi yang sama dapat digunakan penyerang untuk mencari jalan masuk.
Itulah sebabnya model Claude yang tersedia secara umum tetap memiliki cyber safeguards.
Anthropic menjelaskan model publik masih dapat digunakan untuk secure code review, threat modeling, memperbaiki kerentanan yang sudah diketahui, menemukan masalah dalam source code sendiri, serta melakukan triage security alerts.
Permintaan seperti analisis malware atau validasi exploit dapat lebih sering diblokir.
Program verifikasi dibuat untuk mengurangi hambatan tersebut bagi profesional yang memang membutuhkan kemampuan lebih luas.
Project Glasswing Menjadi Dasar Perluasan
Salah satu alasan Anthropic memperbesar program berasal dari Project Glasswing.
Inisiatif ini sebelumnya mempertemukan perusahaan seperti Amazon Web Services, Apple, Cisco, CrowdStrike, Google, Microsoft, Nvidia, Palo Alto Networks, JPMorganChase, Broadcom, serta Linux Foundation.
Tujuannya adalah menggunakan AI untuk membantu menemukan kerentanan dalam software penting.
Hasil awalnya cukup besar.
Anthropic menyebut mitra Glasswing menemukan sedikitnya 129.000 kerentanan software yang sudah diverifikasi antara April dan Juli 2026.
Lebih dari 33.000 di antaranya telah dikategorikan sebagai critical atau high severity.
Anthropic sendiri menemukan tambahan sekitar 5.500 kerentanan melalui scanning open-source antara April hingga Oktober.
Perusahaan mengatakan jumlah sesungguhnya kemungkinan lebih tinggi karena data tersebut berasal dari survei sebagian mitra saja.
AI Bisa Mempercepat Pencarian Bug
Software modern memiliki basis kode yang sangat besar.
Tim keamanan manusia tidak mungkin membaca setiap baris dengan kecepatan yang sama seperti mesin.
Model AI dapat membantu menelusuri source code, mencari pola berbahaya, membandingkan fungsi, serta memprioritaskan area yang perlu diperiksa.
Keunggulan tersebut tidak berarti AI dapat bekerja tanpa manusia.
Temuan perlu diverifikasi.
Sebuah model dapat menghasilkan false positive.
Ia juga dapat salah memahami konteks sebuah sistem.
Karena itu, AI lebih realistis ditempatkan sebagai alat yang meningkatkan kapasitas tim keamanan daripada pengganti penuh security engineer.
Pengaman Tidak Dihapus untuk Semua Pengguna
Hal penting dari pengumuman baru ini adalah Anthropic tidak membuka kemampuan cyber secara bebas.
Akses dengan pengamanan lebih longgar hanya tersedia untuk organisasi yang lolos verifikasi.
Dalam pengujian internal CyScenarioBench, Anthropic menunjukkan perbedaan jelas antara tingkat akses.
Defense tier pada Claude Opus 5.5 memblokir 46 dari 50 tugas yang diuji.
Sementara Red Team tier tidak memblokir tugas dalam benchmark tersebut dan menyelesaikan 34 dari 50.
Angka ini memperlihatkan classifier keamanan memang menjadi bagian utama perbedaan antar-tier.
Model dasarnya bisa sama.
Yang berubah adalah seberapa besar sistem mengizinkan jenis permintaan tertentu.
Verifikasi Menjadi Bagian Kunci
Semakin kuat kemampuan model untuk mencari kelemahan, semakin besar risiko jika akses jatuh ke pihak yang salah.
Karena itu, Anthropic melakukan pemeriksaan terhadap pemohon program.
Reuters melaporkan proses tersebut juga melibatkan kerja sama dengan pemerintah Amerika Serikat untuk memverifikasi organisasi tertentu.
Pendekatan ini mencoba menciptakan keseimbangan.
Tim pertahanan tidak ingin model terlalu sering menolak pekerjaan yang sah.
Di sisi lain, perusahaan tidak ingin fitur yang sama berubah menjadi alat otomatis untuk penyerang.
Masalahnya tidak mudah diselesaikan hanya dengan filter kata.
Security research sering membutuhkan kode exploit untuk membuktikan sebuah kerentanan benar-benar dapat digunakan.
AI Cybersecurity Semakin Kompetitif
Anthropic bukan satu-satunya perusahaan yang melihat keamanan siber sebagai area penting untuk model frontier.
Google sebelumnya juga mengembangkan model dan sistem AI khusus untuk menemukan serta memperbaiki celah kode.
AiHariIni bahkan sudah membahas Gemini 3.5 Flash Cyber sebagai model yang distribusinya dibatasi kepada pemerintah serta mitra terverifikasi.
Perkembangan ini menunjukkan pola baru.
Perusahaan AI tidak hanya bersaing pada chatbot, coding, atau multimodal.
Cybersecurity mulai menjadi arena tersendiri.
Model yang mampu memahami codebase besar, menemukan bug, membuat patch, dan menguji solusi berpotensi mengubah pekerjaan security engineering.
Namun kemampuan ofensif dan defensif sangat sulit dipisahkan.
Klaim 129 Ribu Kerentanan Perlu Dibaca dengan Tepat
Angka 129.000 terdengar sangat besar.
Namun angka tersebut tidak berarti Claude sendirian menemukan 129.000 zero-day kritis.
Anthropic menyatakan angka tersebut berasal dari kerentanan terverifikasi yang dilaporkan mitra Project Glasswing.
Sebagian memiliki tingkat keparahan berbeda.
Sekitar 33.000 sejauh ini mendapat klasifikasi critical atau high severity.
Konteks ini penting agar angka tidak berubah menjadi klaim berlebihan.
Program tersebut juga melibatkan banyak organisasi dan proses verifikasi manusia.
AI menjadi bagian dari sistem pencarian, bukan satu-satunya aktor.
Claude Semakin Difokuskan untuk Penggunaan Profesional
Perluasan Cyber Verification Program hadir hanya beberapa hari setelah Anthropic mengumumkan Claude Frontier Academy untuk melatih engineer enterprise.
Dua pengumuman tersebut menunjukkan arah yang serupa.
Anthropic sedang memperdalam penggunaan Claude di lingkungan profesional yang membutuhkan akses dan dukungan lebih khusus.
Untuk pengguna umum, perubahan program mungkin tidak terlihat langsung.
Claude sehari-hari tetap memiliki batas keamanan.
Namun bagi tim cybersecurity, model yang lebih sedikit memblokir pekerjaan sah dapat mempercepat proses investigasi.
Keberhasilan akhirnya akan bergantung pada dua hal.
Pertama, apakah akses tambahan benar-benar membantu tim pertahanan menemukan dan memperbaiki bug lebih cepat.
Kedua, apakah sistem verifikasi cukup kuat untuk mencegah kemampuan tersebut disalahgunakan.